
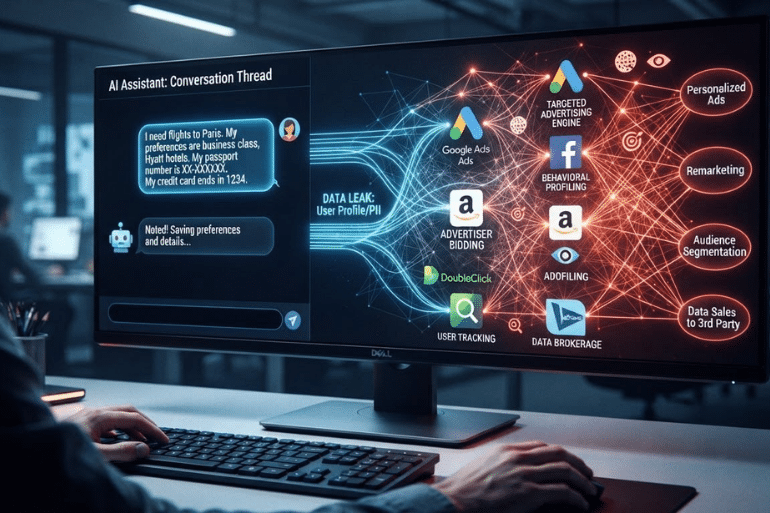
Investigadores del IMDEA Networks y la Universidad Carlos III de Madrid han detectado transferencias de datos conversacionales hacia rastreadores publicitarios en varios de los principales asistentes de IA.
La inteligencia artificial ha entrado en una zona especialmente delicada de la vida digital: las conversaciones privadas.

Millones de usuarios preguntan a ChatGPT, Gemini, Claude, Grok o Perplexity cuestiones personales, médicas, laborales y financieras sin imaginar necesariamente qué información puede salir del entorno del chatbot.
Una nueva investigación realizada por científicos del Instituto IMDEA Networks y la Universidad Carlos III de Madrid ha identificado precisamente ese problema: varios asistentes de inteligencia artificial incorporan mecanismos de rastreo que pueden transmitir a terceros títulos de conversaciones, preguntas, documentos enviados e incluso capturas de pantalla.
El estudio ha sido aceptado en Privacy Enhancing Technologies Symposium (PETS), una de las principales conferencias académicas internacionales dedicadas a privacidad y tecnologías de protección de datos. Sus resultados ya han sido comunicados a la Agencia Española de Protección de Datos (AEPD), que ha trasladado el asunto al Comité Europeo de Protección de Datos para analizar sus posibles implicaciones.
ChatGPT, Gemini y Claude quedan bajo la lupa por sus rastreadores
Los investigadores analizaron nueve asistentes de IA, tanto en sus versiones web como en aplicaciones móviles.
El experimento no se limitó a comprobar qué datos aparecían en las políticas de privacidad. Los investigadores realizaron conversaciones reales con los servicios y utilizaron consultas relacionadas con la salud, acompañándolas de documentos que contenían resultados médicos.
Después observaron qué información era transmitida a servicios externos bajo diferentes configuraciones de privacidad.
El resultado fue especialmente relevante en las versiones web.
Según el estudio, seis de las nueve versiones web analizadas —ChatGPT, Gemini, Claude, Grok, Perplexity y Mistral— enviaban datos directos relacionados con la conversación a sistemas de rastreo publicitario.
En las aplicaciones móviles, los investigadores identificaron este comportamiento en ChatGPT, Claude y Perplexity.
La cuestión no se limita, por tanto, a saber si una empresa de IA conserva internamente una conversación. El estudio pone el foco en qué información sale del servicio y llega a infraestructuras de terceros.
Qué información puede acabar fuera del chatbot
Uno de los aspectos más sensibles de la investigación es la naturaleza de los datos detectados.
Entre la información que los investigadores encontraron en sus pruebas aparecen:
- Títulos de conversaciones.
- Preguntas formuladas al chatbot.
- Documentos subidos por los usuarios.
- Capturas de pantalla.
- Enlaces a determinadas conversaciones.
- Identificadores y datos técnicos utilizados para asociar la actividad con usuarios o dispositivos.
Un título aparentemente inocente puede revelar mucho.
Una conversación denominada, por ejemplo, «Síntomas iniciales de Parkinson» permite inferir una preocupación médica aunque el contenido completo de la conversación no sea transmitido.
Lo mismo puede ocurrir con consultas relacionadas con divorcios, problemas económicos, enfermedades, conflictos laborales o cuestiones jurídicas.
Ese es uno de los riesgos que destacan los investigadores: los metadatos pueden revelar información altamente sensible incluso cuando no se comparte todo el contenido del chat.
El problema no sería solo la publicidad
La investigación pone el foco en un sistema tecnológico mucho más amplio que el simple anuncio que aparece en una página web.
Los rastreadores publicitarios permiten construir perfiles sobre los intereses y comportamientos de los usuarios.
Cuando esos mecanismos reciben información relacionada con las conversaciones de una IA, existe la posibilidad de asociar determinados intereses con identificadores utilizados para seguir la actividad de una persona en diferentes servicios.
Los investigadores advierten de que esto puede permitir a terceros vincular las interacciones con perfiles individuales y patrones de comportamiento a largo plazo.
En otras palabras, el riesgo no consiste únicamente en que alguien conozca qué pregunta se hizo a una IA.
También está en que esa información pueda convertirse en una pieza más de un perfil digital mucho más amplio.
Rechazar las cookies no garantiza que desaparezca el rastreo
Uno de los resultados más llamativos del estudio afecta precisamente a una de las herramientas que los internautas utilizan habitualmente para intentar proteger su privacidad.
Según los investigadores, hasta el 80,8 % de los rastreadores de terceros permanecieron activos incluso cuando se aplicaban determinadas configuraciones de protección, como rechazar cookies o utilizar navegación privada.
Esto resulta especialmente relevante porque muchos usuarios consideran que rechazar las cookies constituye una barrera suficiente frente al seguimiento comercial.
El estudio cuestiona esa percepción.
La privacidad en los servicios digitales depende de mecanismos mucho más complejos que una simple ventana de consentimiento.
Grok aparece como el caso más extremo
Entre los servicios analizados, Grok, desarrollado por xAI, aparece como el caso que los investigadores consideran más problemático.
Según sus pruebas, la versión web transmitía automáticamente información relacionada con las conversaciones a siete redes externas de publicidad y analítica, entre ellas servicios de Meta, TikTok, Google Ads y Twitter Analytics.
El problema se agravaba con los enlaces para compartir conversaciones.
Los investigadores aseguran que, en determinadas circunstancias, esos enlaces podían quedar expuestos a sistemas de rastreo.
En sus pruebas, las conversaciones de Grok llegaron a recibir hasta 70 accesos automáticos de rastreadores procedentes de 14 países.
Este punto requiere una precisión importante: que un rastreador acceda técnicamente a un recurso no significa necesariamente que una persona haya leído manualmente la conversación.
El problema identificado por los investigadores es que la infraestructura permite que información asociada a esas conversaciones sea capturada por sistemas externos.
Los investigadores detectaron además un problema de seguridad
El estudio distingue entre prácticas de recopilación de datos y vulnerabilidades de seguridad.
Según sus autores, la mayoría de los comportamientos identificados parecen responder a decisiones deliberadas de diseño o funcionamiento del producto, no a fallos de seguridad que un atacante pueda explotar.
Sin embargo, encontraron una excepción relevante en Grok relacionada con los controles de acceso a determinados recursos de las conversaciones.
Los investigadores comunicaron este problema a xAI el 17 de abril.
Según el estudio, posteriormente no se produjo una corrección que eliminara la exposición por defecto de determinados enlaces compartidos.
El caso resulta especialmente sensible porque un enlace que permite compartir una conversación puede terminar funcionando como una puerta de acceso mucho más amplia de lo que el usuario imagina.
Google niega que Gemini utilice los datos para publicidad
La investigación también recoge la respuesta de algunas de las grandes compañías afectadas.
Google rechazó las conclusiones del informe respecto a Gemini.
Una portavoz de la compañía afirmó que el estudio malinterpreta el funcionamiento del producto y señaló que Gemini no incorpora anuncios. Google explicó que utiliza herramientas como Google Analytics para cuestiones relacionadas con el funcionamiento técnico, las interrupciones y la fiabilidad del servicio, y aseguró cumplir la normativa europea de privacidad.
Esta respuesta es importante porque introduce una diferencia entre dos conceptos que no deberían confundirse: que una plataforma transmita información a una herramienta de analítica no demuestra automáticamente que esa información se utilice para vender publicidad personalizada.
Eso es precisamente lo que debe determinarse en cada caso.
OpenAI también rechaza el uso publicitario de los datos
OpenAI ofreció igualmente su explicación.
La compañía afirmó que las herramientas de analítica utilizadas por ChatGPT sirven para comprender el tráfico, diagnosticar errores y supervisar el rendimiento del servicio.
Además, según la respuesta recogida por elDiario.es, OpenAI asegura que esa información no se utiliza con fines publicitarios ni se vende o comparte con anunciantes.
Por tanto, existe una diferencia entre lo que los investigadores han observado técnicamente —la transmisión de determinados datos a herramientas de terceros— y la finalidad que las empresas atribuyen a esas transferencias.
La investigación pone sobre la mesa el primer punto.
Las compañías niegan que ello implique utilizar las conversaciones para publicidad.
Microsoft también rechaza haber incumplido la normativa
Microsoft respondió a las acusaciones afirmando que, después de examinarlas, no había encontrado ninguna infracción de la legislación aplicable ni de su declaración de privacidad.
La compañía defendió además que la privacidad constituye una prioridad para sus servicios, incluido Copilot.
El caso muestra así una cuestión fundamental: detectar una transferencia de datos no equivale por sí mismo a demostrar una infracción legal.
La posible ilegalidad dependerá, entre otros elementos, de qué datos se transfieren, a quién, con qué base jurídica, para qué finalidad, qué información se proporciona al usuario y qué mecanismos de control existen.
La investigación ya está sobre la mesa de las autoridades europeas
El estudio no se ha quedado en el ámbito académico.
Los investigadores comunicaron sus resultados a la Agencia Española de Protección de Datos, que posteriormente elevó el asunto al Comité Europeo de Protección de Datos (EDPB).
Este organismo europeo mantiene además desde hace años una investigación sobre el tratamiento de datos de ChatGPT, por lo que las nuevas conclusiones podrían incorporarse a un debate regulatorio que ya estaba abierto.
La cuestión resulta especialmente relevante en Europa debido al marco de protección establecido por el Reglamento General de Protección de Datos (RGPD).
Sin embargo, cualquier conclusión jurídica deberá proceder de las autoridades competentes.
A día de hoy, la investigación académica demuestra determinados comportamientos técnicos, pero no permite afirmar por sí sola que todas las empresas analizadas hayan cometido una infracción del RGPD.
El problema llega en un momento delicado para la IA
La investigación aparece además cuando los grandes modelos de inteligencia artificial están incorporando cada vez más servicios y usuarios.
Los chatbots han dejado de utilizarse únicamente para redactar textos o resolver dudas.
Ahora se emplean para:
- Consultar problemas de salud.
- Analizar documentos privados.
- Preparar asuntos jurídicos.
- Revisar contratos.
- Gestionar cuestiones laborales.
- Resolver problemas financieros.
- Analizar fotografías y documentos.
- Compartir información empresarial.
Precisamente por eso, la cantidad y sensibilidad de los datos que pueden llegar a un chatbot ha aumentado enormemente.
El usuario puede percibir la conversación como un diálogo privado, pero detrás de esa interfaz existe una compleja infraestructura tecnológica compuesta por servidores, herramientas de analítica, redes de distribución y servicios de terceros.
Un estudio anterior ya había advertido del problema
La nueva investigación no aparece completamente aislada.
En mayo de 2026, otra investigación ya había detectado mecanismos de rastreo relacionados con ChatGPT, Claude, Grok y Perplexity, incluidos rastreadores vinculados a empresas como Meta, Google y TikTok.
Aquella investigación ya había advertido de un riesgo particularmente delicado: algunos asistentes podían exponer información como el título de las conversaciones y determinados enlaces, permitiendo inferir la naturaleza de las consultas realizadas.
La nueva investigación amplía el número de servicios analizados y profundiza en la información que puede ser transmitida.
Por eso, el debate ya no se limita a una aplicación concreta.
La gran pregunta: ¿qué ocurre cuando el usuario pulsa «enviar»?
Durante años, la privacidad en internet se ha explicado fundamentalmente mediante cookies, historiales de navegación y publicidad personalizada.
Los chatbots introducen una diferencia sustancial.
Un usuario puede escribir voluntariamente información que jamás introduciría en un buscador convencional.
Puede contarle a una IA qué enfermedad cree tener, cuánto dinero debe, qué problemas tiene en su matrimonio o qué conflicto mantiene con su empresa.
La información es potencialmente mucho más íntima.
Por eso, el problema planteado por los investigadores afecta a una cuestión básica: qué grado de privacidad cree tener el usuario frente al que realmente proporciona la arquitectura tecnológica del servicio.
Qué debería evitar un usuario al utilizar una IA
Mientras las autoridades analizan las implicaciones de estos hallazgos, existe una precaución sencilla que no depende de ninguna compañía: no introducir en un chatbot información sensible que no sea imprescindible.
Algunas recomendaciones prácticas son:
- No introducir contraseñas ni claves de acceso.
- Evitar enviar documentos con datos personales innecesarios.
- No incluir números completos de tarjetas bancarias.
- Evitar información médica identificable cuando no sea imprescindible.
- No compartir documentos laborales confidenciales sin revisar antes sus datos.
- Comprobar las opciones de privacidad y conservación de conversaciones del servicio utilizado.
- Tener especial precaución con los enlaces públicos para compartir chats.
Estas medidas no solucionan los problemas estructurales detectados por el estudio, pero reducen la cantidad de información sensible que queda expuesta en primer lugar.
La privacidad se convierte en uno de los grandes desafíos de la IA
La investigación de los científicos españoles plantea una paradoja.
La inteligencia artificial pretende convertirse en un asistente cada vez más personal, capaz de conocer el contexto de cada usuario para ofrecer respuestas más útiles.
Pero cuanto más personal sea la interacción, más sensible será también la información que puede llegar a recopilarse.
El desafío consiste en determinar hasta dónde puede llegar esa personalización sin convertir las conversaciones en otra fuente de datos para el ecosistema publicitario y de analítica digital.
Los investigadores consideran que los asistentes conversacionales han incorporado parte de la infraestructura de rastreo que ya existe en internet y que esto crea una nueva superficie de exposición para la privacidad.
Y esa cuestión afecta por igual a usuarios de todos los grandes servicios.
 Toqueteo
 Toqueteo
 Toqueteo