
La evolución del asistente de programación de Microsoft apunta a una mayor integración con Windows, con ejecución de modelos de inteligencia artificial en el propio dispositivo y entornos aislados para tareas de desarrollo. El cambio abre nuevas posibilidades para la privacidad del código y el control empresarial de la IA.
GitHub Copilot avanza hacia una nueva etapa en la que la inteligencia artificial para programadores no dependerá exclusivamente de servicios ejecutados en la nube. La integración prevista de modelos locales y entornos de ejecución seguros en Windows podría permitir a los desarrolladores trabajar con mayores controles sobre sus herramientas, su código y los procesos automatizados.

La información, adelantada por Digital Inside, sitúa el foco en dos capacidades: ejecutar modelos de inteligencia artificial en el propio equipo y disponer de entornos aislados para determinadas operaciones de programación.
Ambas tecnologías responden a una preocupación creciente en el sector: cómo aprovechar asistentes capaces de escribir código y ejecutar tareas sin concederles acceso indiscriminado al ordenador del usuario.
El interés es especialmente relevante para empresas que desarrollan software propio, trabajan con información confidencial o necesitan controlar qué datos salen de sus infraestructuras.
La propuesta también refleja un cambio en la industria. Los asistentes de programación están evolucionando desde herramientas que sugieren líneas de código hacia sistemas capaces de participar en procesos completos de desarrollo.
GitHub Copilot quiere reducir su dependencia de la nube
GitHub Copilot es una herramienta de asistencia a la programación desarrollada por GitHub, compañía propiedad de Microsoft.
Su función principal consiste en ayudar a los desarrolladores a escribir, comprender, revisar y modificar código mediante inteligencia artificial.
Tradicionalmente, muchas de estas operaciones han dependido de modelos ejecutados en servidores remotos.
El usuario envía una solicitud y recibe una respuesta generada por la infraestructura del proveedor.
La incorporación de modelos locales plantea una alternativa.
Un modelo local de inteligencia artificial se ejecuta directamente en el ordenador del usuario, utilizando sus recursos de procesamiento y memoria.
Esta modalidad puede ofrecer ventajas en determinados escenarios.
Por ejemplo, puede reducir la necesidad de transmitir información a servicios externos y facilitar algunas operaciones cuando la conectividad es limitada.
Sin embargo, no significa que cualquier función de Copilot pueda funcionar sin internet ni que los modelos locales alcancen necesariamente las mismas capacidades que los sistemas más grandes ejecutados en centros de datos.
El rendimiento dependerá del hardware disponible, del tamaño del modelo y de las tareas que deba realizar.
Qué ventajas puede aportar la ejecución de modelos locales
La ejecución local de inteligencia artificial resulta especialmente interesante para los equipos de desarrollo que manejan código sensible.
Entre sus posibles ventajas destacan:
- Mayor control sobre los datos: determinadas operaciones pueden realizarse sin enviar el contenido procesado a un servidor remoto.
- Menor dependencia de la conexión: algunas funciones pueden seguir disponibles cuando no existe acceso permanente a internet.
- Reducción de latencia: ciertas solicitudes pueden resolverse directamente en el equipo, sin esperar una comunicación con la nube.
- Flexibilidad empresarial: las organizaciones pueden estudiar qué tareas conviene ejecutar localmente y cuáles necesitan modelos remotos más potentes.
Estas ventajas no son automáticas.
Un modelo local sigue necesitando controles de acceso, mantenimiento y medidas de protección.
Además, el código generado debe revisarse igual que el producido por cualquier otra herramienta de inteligencia artificial.
La ejecución local puede mejorar el control técnico sobre determinadas operaciones, pero no garantiza por sí sola la confidencialidad absoluta ni la ausencia de vulnerabilidades.
Microsoft prepara un sistema que elegirá entre la nube y el ordenador
La actualización anunciada incorpora una capacidad especialmente relevante: GitHub Copilot podrá decidir automáticamente dónde ejecutar determinadas tareas de inteligencia artificial.
Según la información publicada por Digital Inside, basada en explicaciones técnicas de Microsoft, el asistente podrá seleccionar entre los servidores remotos y el procesamiento local.
La elección dependerá de las características de cada operación y de los recursos disponibles.
El objetivo es encontrar un equilibrio entre velocidad, rendimiento, coste y capacidad de procesamiento.
Hasta ahora, los asistentes de programación han dependido en gran medida de modelos alojados en centros de datos.
La nueva arquitectura pretende combinar esa capacidad con la ejecución en dispositivos compatibles.
Esto permitirá que determinadas tareas se procesen localmente mientras otras continúan utilizando infraestructura remota.
La transición entre ambos entornos estará diseñada para conservar el contexto de trabajo.
Los desarrolladores no tendrán que decidir manualmente en cada solicitud qué infraestructura debe utilizarse, aunque también podrán seleccionar expresamente un modelo local cuando lo consideren necesario.
MAI Code 1.1 Flash: el modelo de 137 000 millones de parámetros
Uno de los anuncios técnicos más importantes es la adaptación de MAI Code 1.1 Flash para su ejecución local.
Según Digital Inside, Microsoft ha desarrollado una versión optimizada de este modelo especializado en programación.
Sus características anunciadas son las siguientes:
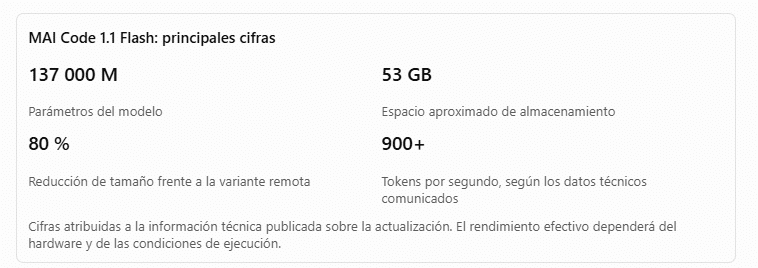
El número de parámetros refleja una característica de la arquitectura del modelo, aunque no determina por sí solo su calidad.
La reducción de tamaño se consigue mediante técnicas de cuantización.
Este procedimiento permite representar determinados valores del modelo con una precisión numérica menor, reduciendo la memoria necesaria para almacenarlo y ejecutarlo.
La cuantización puede hacer viable el uso local de modelos que, en su formato original, exigirían recursos considerablemente superiores.
Sin embargo, reducir el tamaño de un modelo no significa que cualquier ordenador pueda ejecutarlo con fluidez.
La memoria disponible, el procesador gráfico y la configuración del sistema seguirán siendo factores determinantes.
Microsoft busca acelerar la generación de código
La versión local de MAI Code 1.1 Flash también incorpora técnicas destinadas a mejorar la velocidad de respuesta.
Entre ellas destaca la descodificación especulativa, un método que permite acelerar la generación de resultados mediante un proceso de predicción y verificación.
Según los datos técnicos recogidos por Digital Inside, el sistema puede superar los 900 tokens por segundo en determinadas condiciones.
Un token es una unidad de información utilizada por los modelos de lenguaje para procesar y generar contenido.
No equivale necesariamente a una palabra completa.
En programación, los tokens pueden representar fragmentos de instrucciones, símbolos o elementos del código.
Una velocidad elevada puede resultar útil para tareas como la generación de funciones, la explicación de programas o la revisión de archivos.
Microsoft también señala que la optimización busca mantener la calidad del código generado.
No obstante, una mayor velocidad de generación no garantiza que el código sea correcto, seguro o adecuado para su utilización en producción.
Los resultados deberán someterse a pruebas y revisiones.
Los 128 GB de memoria unificada, una exigencia para determinados equipos
La ejecución local de modelos grandes plantea importantes requisitos de hardware.
La información publicada menciona dispositivos de alto rendimiento basados en tecnología NVIDIA, con arquitecturas de memoria unificada que pueden alcanzar los 128 GB.
En estos sistemas, la memoria puede compartirse entre la unidad central de procesamiento y los recursos gráficos.
Esta arquitectura facilita el trabajo con modelos de gran tamaño.
Sin embargo, la inteligencia artificial no es el único componente que necesita memoria.
El sistema operativo, el entorno de desarrollo y las demás aplicaciones también consumen recursos.
Además, cuando un agente analiza archivos y mantiene conversaciones prolongadas, necesita gestionar un contexto de trabajo cada vez mayor.
Por tanto, el reto consiste en conservar una velocidad de respuesta estable sin comprometer el funcionamiento del resto del ordenador.
Los equipos empresariales convencionales no deben considerarse automáticamente compatibles con modelos locales de estas dimensiones.
La disponibilidad real dependerá de los requisitos que Microsoft establezca para cada configuración.
Copilot permitirá elegir manualmente el modelo local
Además de la selección automática entre nube y dispositivo, los desarrolladores podrán optar expresamente por un modelo local.
Esta posibilidad resulta importante para proyectos con requisitos técnicos específicos.
Por ejemplo, una empresa podría preferir que determinadas tareas relacionadas con código interno se ejecuten dentro de su propia infraestructura.
En otros casos, podría resultar más conveniente utilizar modelos remotos de mayor capacidad.
La nueva arquitectura pretende ofrecer ambas posibilidades dentro del flujo habitual de trabajo.
El objetivo no es eliminar la nube, sino permitir una distribución más flexible de las tareas de inteligencia artificial.
Esta estrategia también puede ayudar a optimizar el uso de recursos.
Las operaciones sencillas podrían procesarse mediante modelos locales, mientras que las solicitudes más exigentes utilizarían infraestructura externa.
Sin embargo, las empresas deberán comprobar qué datos se envían a cada entorno y cómo se aplican las políticas de seguridad.
GitHub Copilot incorporará contenedores para ejecutar tareas con seguridad
La segunda gran novedad anunciada afecta a la ejecución de herramientas.
Los agentes de inteligencia artificial modernos no se limitan a generar texto.
También pueden utilizar comandos, consultar archivos, ejecutar pruebas y modificar proyectos de programación.
Estas capacidades aumentan su utilidad, pero introducen nuevos riesgos.
Cuando una herramienta automatizada ejecuta comandos con los permisos del usuario, puede acceder a recursos que no necesita para completar su tarea.
Un error de interpretación o una instrucción maliciosa podrían provocar cambios no deseados.
Para reducir este riesgo, Microsoft plantea utilizar entornos de ejecución aislados.
Estos espacios permiten establecer restricciones sobre los archivos, las conexiones de red y las credenciales a las que puede acceder un agente.
El propósito es impedir que una tarea automatizada disponga de más privilegios de los necesarios.
Microsoft Execution Containers: aislamiento sin máquinas virtuales completas
La tecnología presentada recibe el nombre de Microsoft Execution Containers.
Se trata de un sistema de código abierto que utiliza mecanismos de aislamiento disponibles en diferentes sistemas operativos.
A diferencia de una máquina virtual tradicional, estos entornos no necesitan necesariamente ejecutar una copia completa de otro sistema operativo.
En su lugar, aprovechan funciones de seguridad y aislamiento de la plataforma.
La implementación descrita contempla distintos mecanismos según el sistema utilizado.
| Sistema operativo | Tecnología de aislamiento |
|---|---|
| Windows | Contenedores y aislamiento de procesos |
| macOS | Seatbelt |
| Linux | Bubblewrap |
Esta arquitectura pretende facilitar el uso de herramientas automatizadas en entornos de desarrollo heterogéneos.
Un agente podría, por ejemplo, analizar un repositorio y generar un informe sobre cambios recientes sin disponer de acceso general a todos los archivos del ordenador.
La eficacia de este aislamiento dependerá de su configuración y de las capacidades de seguridad de cada plataforma.
Los contenedores reducen la exposición de determinados recursos, pero no constituyen una garantía absoluta frente a todos los ataques.
El riesgo de que una IA ejecute comandos con permisos excesivos
La incorporación de agentes autónomos al desarrollo de software está cambiando la naturaleza de los riesgos.
Un asistente que únicamente propone código puede cometer errores que el programador debe revisar.
Pero un agente capaz de ejecutar herramientas puede producir efectos directos sobre el sistema.
Entre las operaciones sensibles figuran la modificación de archivos, la ejecución de comandos y el acceso a credenciales.
También existe el riesgo de que un agente interprete como instrucciones legítimas contenido malicioso incluido en archivos o documentación.
Este problema se conoce como inyección de instrucciones o prompt injection.
Los entornos aislados pueden limitar el alcance de algunas de estas situaciones.
Por ejemplo, una tarea que no necesita acceso a internet puede ejecutarse con las conexiones de red restringidas.
Del mismo modo, un agente encargado de analizar un repositorio no debería recibir automáticamente permisos para consultar archivos personales.
El principio de mínimo privilegio será fundamental para utilizar agentes de programación de forma segura.
Qué cambia para las empresas que utilizan GitHub Copilot
La combinación de modelos locales y ejecución aislada puede resultar especialmente interesante para los departamentos de desarrollo corporativo.
Las organizaciones suelen trabajar con repositorios privados, credenciales de servicios y documentación interna.
En estos entornos, la utilización de inteligencia artificial exige evaluar cuidadosamente los permisos y el tratamiento de los datos.
La nueva arquitectura de Copilot podría facilitar una separación más clara entre tareas locales y operaciones que necesitan servicios externos.
También permitiría limitar el alcance de determinados comandos ejecutados automáticamente.
Sin embargo, las empresas deberán estudiar los requisitos de hardware, la disponibilidad de las funciones y su integración con las políticas existentes.
No todas las organizaciones necesitan ejecutar modelos de 137 000 millones de parámetros en sus equipos.
Para algunas, puede resultar más eficiente mantener una arquitectura basada en la nube.
Para otras, la ejecución local puede ofrecer ventajas en proyectos concretos.
La elección dependerá del coste total, la sensibilidad de los datos y las necesidades reales de cada equipo de desarrollo.
El coste del hardware será uno de los principales obstáculos
Aunque la ejecución local puede reducir la dependencia de servicios remotos, exige recursos informáticos propios.
Un modelo que ocupa aproximadamente 53 GB necesita una cantidad considerable de memoria y almacenamiento.
Además, para generar resultados con rapidez se requiere hardware capaz de procesar eficientemente sus operaciones.
Esto puede incrementar el coste de los equipos destinados al desarrollo.
Las empresas deberán comparar la inversión en dispositivos de alto rendimiento con el gasto asociado a los modelos alojados en la nube.
También tendrán que considerar el mantenimiento, el consumo energético y la renovación del hardware.
La inteligencia artificial local no es necesariamente más barata que la nube en todos los escenarios.
Puede resultar competitiva cuando existe una utilización intensiva y los recursos se aprovechan adecuadamente.
En cambio, para tareas esporádicas, un servicio remoto puede ofrecer una alternativa más económica.
La información publicada no aporta datos suficientes para calcular un ahorro general aplicable a todas las empresas.
La privacidad del código gana protagonismo en la inteligencia artificial
Uno de los argumentos más relevantes a favor de los modelos locales es la posibilidad de controlar mejor dónde se procesa la información.
En el desarrollo empresarial, el código fuente puede contener conocimientos técnicos, algoritmos propios y detalles sobre la arquitectura de los sistemas.
También puede incluir referencias a servicios internos o información que debe mantenerse protegida.
La ejecución local permite diseñar procesos en los que determinados datos no necesiten enviarse a un modelo remoto.
No obstante, esa ventaja depende de la configuración concreta.
Un asistente puede ejecutar la inferencia localmente y, al mismo tiempo, utilizar otras funciones que requieran conectividad externa.
Por ello, las organizaciones deberán verificar los flujos reales de información.
La privacidad no depende únicamente de dónde se ejecuta el modelo, sino también de qué herramientas utiliza y qué datos transmite.
Microsoft refuerza su estrategia de inteligencia artificial en Windows
La integración de modelos locales en GitHub Copilot encaja con una tendencia más amplia: aprovechar los recursos de procesamiento disponibles en los dispositivos.
Los ordenadores modernos incorporan cada vez más componentes especializados para tareas de inteligencia artificial.
Entre ellos figuran las unidades de procesamiento gráfico y, en determinadas configuraciones, las unidades de procesamiento neuronal.
Estas tecnologías permiten ejecutar operaciones de IA sin depender exclusivamente de servidores externos.
Sin embargo, las necesidades de los modelos varían considerablemente.
Un sistema pequeño destinado a clasificar información no exige los mismos recursos que un modelo avanzado de programación.
La estrategia anunciada por Microsoft pretende coordinar diferentes capacidades de procesamiento.
En lugar de utilizar siempre la misma infraestructura, Copilot podrá seleccionar el entorno más adecuado para determinadas tareas.
El futuro de los asistentes de programación apunta hacia sistemas híbridos que combinan procesamiento local, servicios en la nube y controles de ejecución.
GitHub Copilot evoluciona de asistente a agente de programación
La actualización también refleja una transformación en la manera de utilizar la inteligencia artificial para desarrollar software.
Los primeros asistentes se centraban principalmente en sugerir fragmentos de código.
Posteriormente incorporaron funciones de conversación, explicación y revisión.
La nueva generación de agentes puede participar en procesos más amplios.
Un desarrollador podría solicitar el análisis de un proyecto, la preparación de cambios o la ejecución de determinadas pruebas.
El sistema podría utilizar diferentes herramientas para completar esos pasos.
La incorporación de contenedores seguros pretende hacer más controlable esa autonomía.
Al mismo tiempo, la ejecución local permitiría realizar algunas operaciones directamente en el dispositivo.
No obstante, la responsabilidad sobre el código final seguirá correspondiendo a los profesionales y organizaciones que lo utilizan.
La automatización puede acelerar el desarrollo, pero no sustituye la necesidad de revisar la seguridad, el funcionamiento y la calidad del software.
Una actualización que une rendimiento, autonomía y seguridad
La próxima evolución de GitHub Copilot combina tres líneas tecnológicas: selección automática entre modelos locales y remotos, optimización del procesamiento y ejecución de herramientas en entornos aislados.
La versión local de MAI Code 1.1 Flash, con sus 137 000 millones de parámetros, representa una apuesta por trasladar capacidades avanzadas de programación a equipos compatibles.
Por su parte, Microsoft Execution Containers pretende reducir los riesgos derivados de permitir que agentes automatizados ejecuten comandos y accedan a recursos.
Ambas novedades responden a necesidades reales del desarrollo empresarial.
Las compañías quieren utilizar inteligencia artificial más potente, pero también necesitan controlar los costes, proteger su código y limitar los permisos de las herramientas.
El reto será convertir estas capacidades en soluciones accesibles, fiables y fáciles de administrar.
Microsoft busca que GitHub Copilot deje de depender de un único entorno de ejecución y pueda trabajar allí donde resulte más eficiente y seguro.
La adopción empresarial dependerá de los requisitos de hardware, las condiciones de disponibilidad y los resultados obtenidos en entornos reales.
 Toqueteo
 Toqueteo
 Toqueteo